
Onderzoekers van Microsoft beschrijven in het wetenschappelijke tijdschrift Science van 22 oktober 2026 een AI-systeem dat bij moeilijke medische casussen vaker op de juiste diagnose uitkomt dan algemeen artsen. Het gaat om een gecontroleerde test met gepubliceerde, historische casussen, niet om echte patiënten. De auteurs schrijven zelf dat de studie niet aantoont dat het systeem beter is dan specialisten of dan de zorg in de praktijk.
Hoe de test werkte
Microsoft noemt het systeem MAI-DxO; in Science heet het DxO, kort voor Diagnostic Orchestrator. Het gebruikt een taalmodel, in de studie vooral GPT-5 van OpenAI. Het krijgt een casus stukje bij stukje, net als een arts: het mag vragen stellen en onderzoeken aanvragen, en elk onderzoek kost geld. Zo meten de onderzoekers of de diagnose klopt en wat het onderzoek kost. Een tweede AI-model speelt de ‘poortwachter’ die antwoord geeft op de vragen, op basis van het dossier van de casus.
De onderzoekers gebruikten 304 moeilijke casussen uit de New England Journal of Medicine en 325 casussen van de spoedeisende hulp uit de MIMIC-IV-database.
De uitkomsten
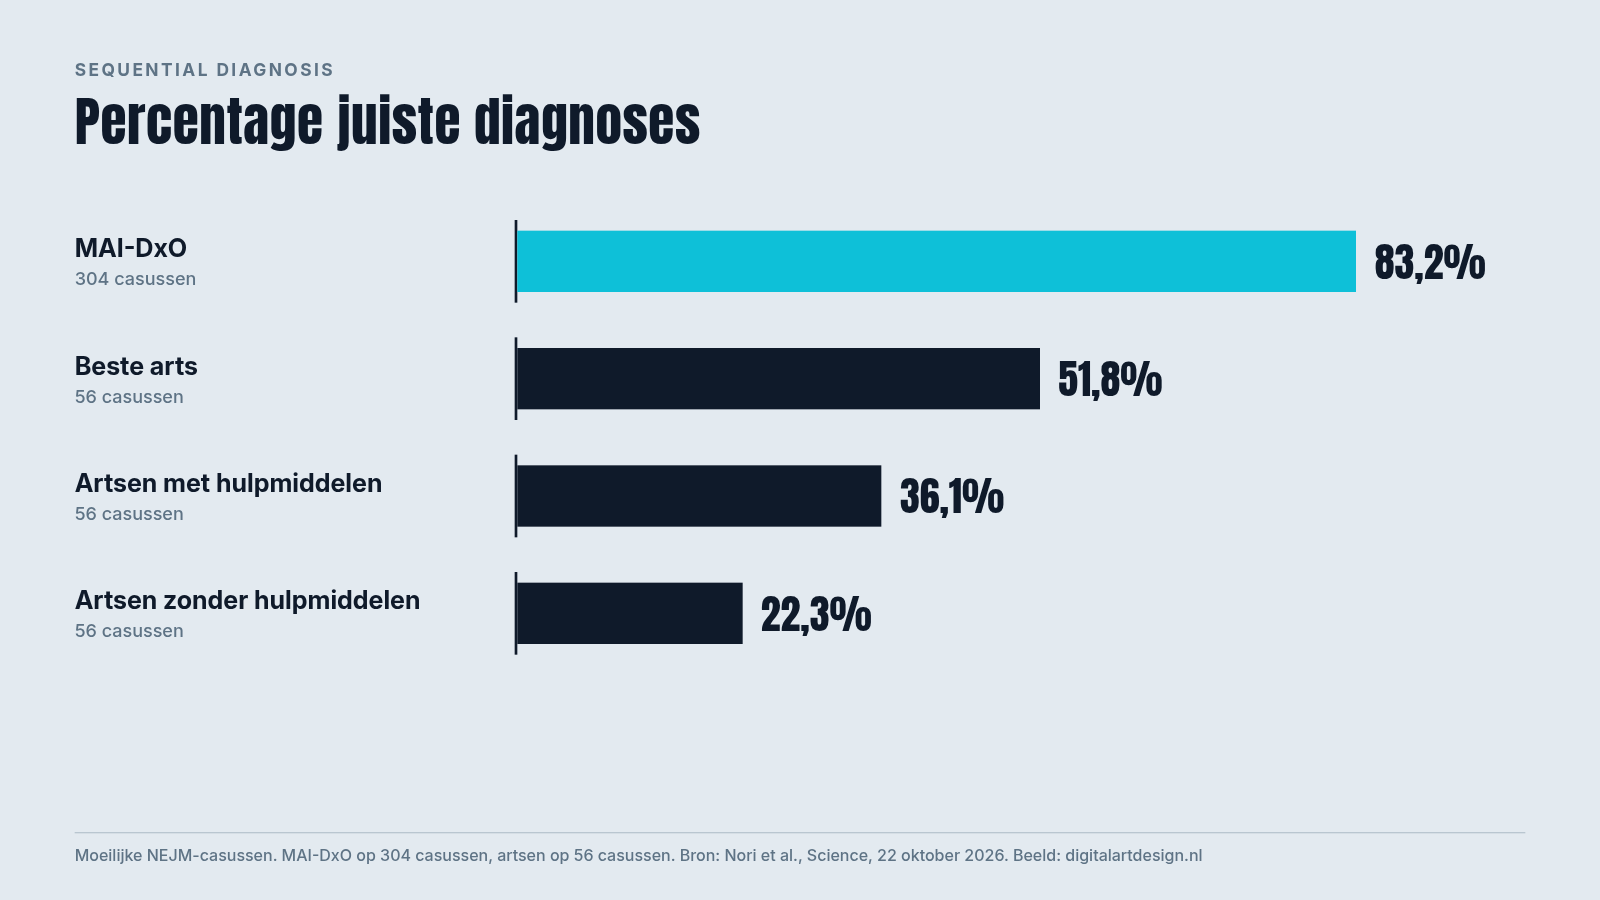
Bij de NEJM-casussen stelde MAI-DxO in 83,2 procent van de gevallen de juiste diagnose, tegen gemiddeld $5.431 aan onderzoeken. In een zuinigere stand was dat 79,6 procent voor $1.303. Bij de spoedeisende-hulpcasussen kwam het systeem op 80,3 procent.
De vergelijking met artsen is kleiner opgezet. Algemeen artsen kregen casussen uit een set van 56 NEJM-casussen die niet voor het ontwikkelen van het systeem waren gebruikt; gemiddeld losten ze er zo’n 35 op. Zonder hulpmiddelen kwamen ze gemiddeld op 22,3 procent, met internet en naslagwerk op 36,1 procent. De beste arts haalde 51,8 procent. Bij de spoedeisende hulp scoorden artsen gemiddeld 46,8 procent.
De kanttekeningen
De poortwachter werkt alleen met tekst. Ook de bevindingen van lichamelijk onderzoek kwamen als tekst uit het dossier; echte patiënten en beeldmateriaal zoals scans kwamen er niet aan te pas. De artsen werkten in de eerstelijnszorg of in het ziekenhuis en de acute zorg; de studie noemt hen ‘generalist physicians’. Ze losten de casussen alleen op, zonder collega’s. De auteurs noemen het zelf een ‘controlled benchmark’ en schrijven dat ze geen superioriteit aantonen ‘over specialists, multidisciplinary teams, or real-world clinical practice’.
Alle auteurs zijn in dienst van Microsoft en hebben aandelen in het bedrijf; Microsoft heeft volgens de verklaring over belangen patent aangevraagd. De code van de test staat onder de MIT-licentie op GitHub, zodat anderen de resultaten kunnen nagaan; de NEJM-casussen zelf zijn alleen onder licentie bij NEJM Group te krijgen.
Microsoft schrijft in een eigen blog dat het werkt aan ‘medical superintelligence’ en kondigt een vervolgstudie aan met echte patiënten in het Beth Israel Deaconess Medical Center in Boston, plus een samenwerking met de Mayo Clinic. Wanneer die resultaten komen, staat er niet bij.
Waarom dit ertoe doet
AI-hulp bij diagnoses komt dichter bij de praktijk, en een publicatie in Science geeft dit onderzoek meer gewicht dan een bedrijfsblog. Tegelijk laat de studie vooral zien wat een systeem kan in een gecontroleerde test met tekst. Of het artsen in de spreekkamer helpt, moet de vervolgstudie met echte patiënten uitwijzen. Tot die tijd is dit geen reden om een chatbot om een diagnose te vragen in plaats van een arts.
Bronnen
- Sequential diagnosis with language models, Harsha Nori e.a., Science 394, 423–428, 22 oktober 2026.
https://www.science.org/doi/10.1126/science.aeh7930 - Building Medical Superintelligence, Microsoft AI, 22 oktober 2026.
https://microsoft.ai/news/building-medical-superintelligence/ - SDBench: Sequential Diagnosis Benchmark (code, MIT-licentie), Microsoft op GitHub, geraadpleegd 30 oktober 2026.
https://github.com/microsoft/sdbench