
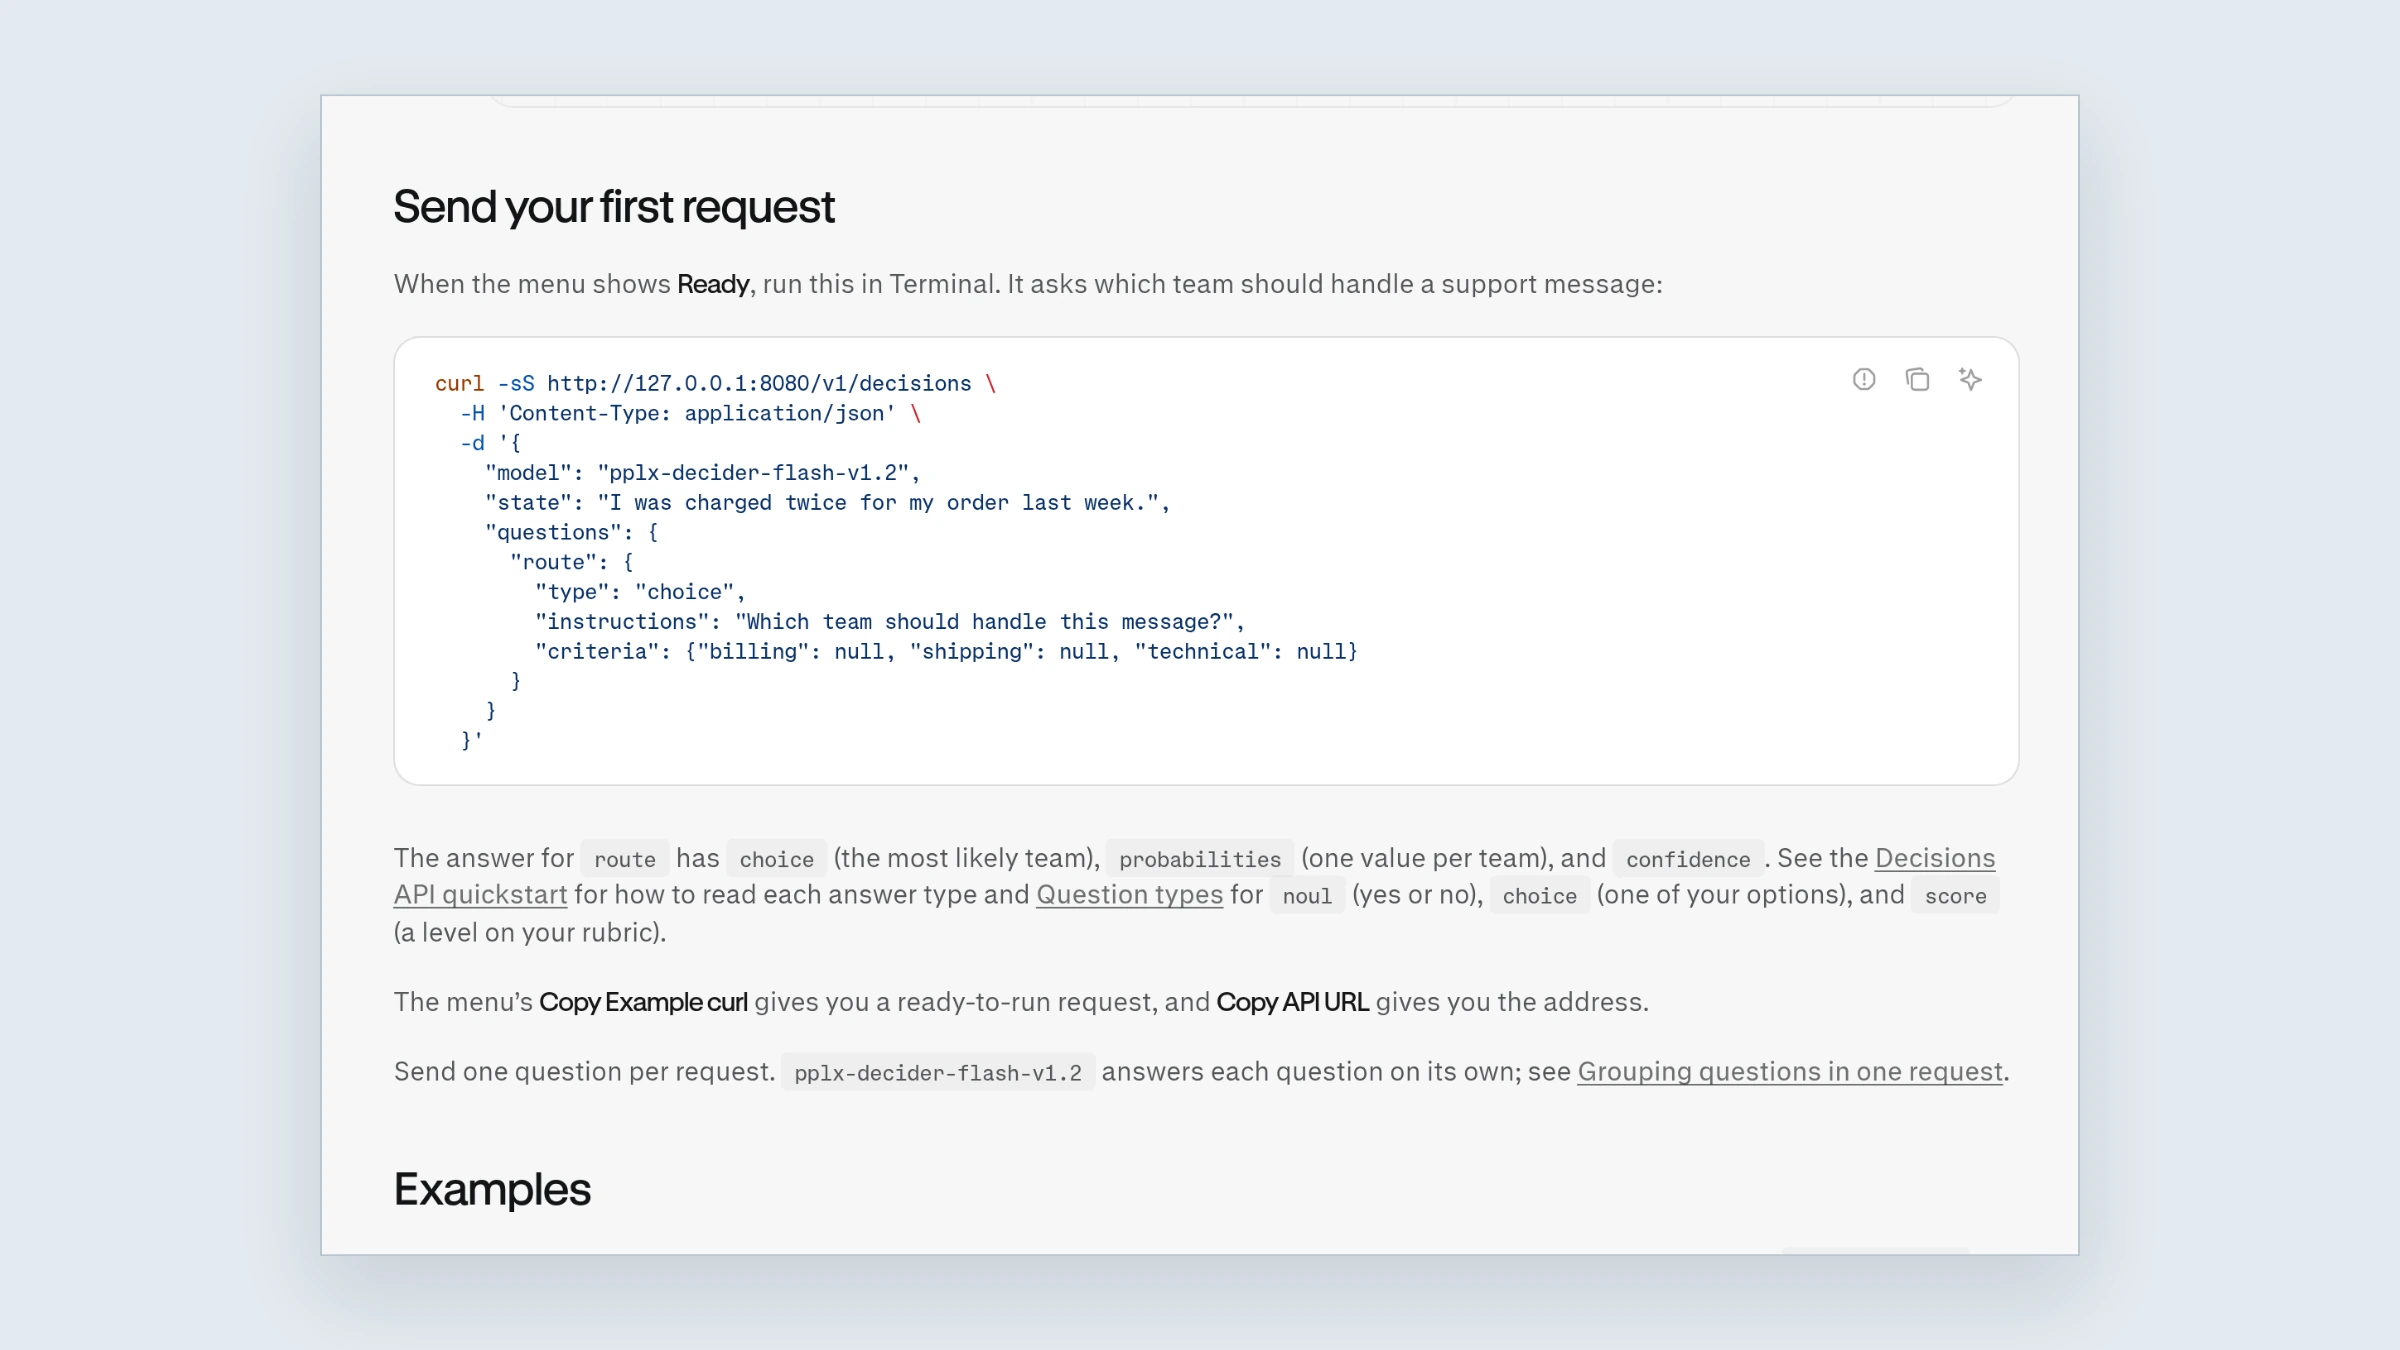
OpenAI en Perplexity bieden sinds oktober 2026 allebei een Decisions API, bij OpenAI sinds 22 oktober algemeen beschikbaar: je stelt een vraag met vaste antwoordopties en krijgt een kans, een keuze of een score terug, geen lopende tekst. Omdat je bij beide alleen betaalt voor wat je erin stopt, is dat voor wie veel kleine beslissingen automatiseert, zoals mail sorteren of verzoeken doorsturen, een goedkopere en snellere route dan een gewone chat-API. Perplexity is per token het goedkoopst en laat je het kleine model zelfs op je eigen Mac draaien.
Wat er is aangekondigd
OpenAI maakte de Decisions API op 22 oktober 2026 algemeen beschikbaar, na een openbare bèta die volgens de changelog van OpenAI op 6 oktober begon. De API draait op GPT-6 Luna. Volgens OpenAI krijg je antwoord tot tien keer sneller dan wanneer je hetzelfde model via de gewone Responses API aanroept. Je kunt tot 400 vragen in één verzoek stellen, twee keer zoveel als in de bèta. De verwerking kan in de VS of de EU plaatsvinden, wat voor Nederlandse bedrijven met privacyeisen telt. Klanten die daarvoor in aanmerking komen, kunnen kiezen voor Zero Data Retention: OpenAI bewaart de gegevens dan niet.
Perplexity biedt een eigen endpoint met dezelfde naam, POST /v1/decisions, met twee eigen modellen: pplx-decider-v1.2 (27 miljard parameters, 27B) en pplx-decider-flash-v1.2 (4 miljard parameters, 4B). Het grote model is gebouwd op Qwen3.8-27B, het kleine op Qwen3.5-4B, beide van Alibaba. Het kleine model is volgens de modelkaart ‘gedistilleerd’ uit het grote: het heeft geleerd de kansverdeling van het grotere model na te bootsen. Volgens de changelog van Perplexity kwam versie 1.2 in oktober 2026 uit en vervangt het grote model de vorige versie, pplx-decider-v1.1-27b.
Hoe een Decisions API werkt
Je stuurt een stuk context mee, bijvoorbeeld een klantmail, een screenshot of een JSON-object, plus een of meer vragen. Elke vraag heeft een vast type. Bij OpenAI heten de drie typen predicate (kans dat iets waar is, van 0 tot 1), choice (een van jouw opties) en score (een niveau op een schaal die je zelf beschrijft). Perplexity heeft hetzelfde drietal, maar noemt het ja/nee-type noul.
Omdat het model geen zinnen schrijft, betaal je bij beide geen outputtokens. Dat maakt de prijs voorspelbaar: wat je instuurt, bepaalt de rekening. Perplexity laat in de documentatie zien dat een verzoek van 600 inputtokens $0,000012 kost op het grote model.
Wat het kost
| Aanbieder en model | Input per miljoen tokens | Gecachte input | Output |
|---|---|---|---|
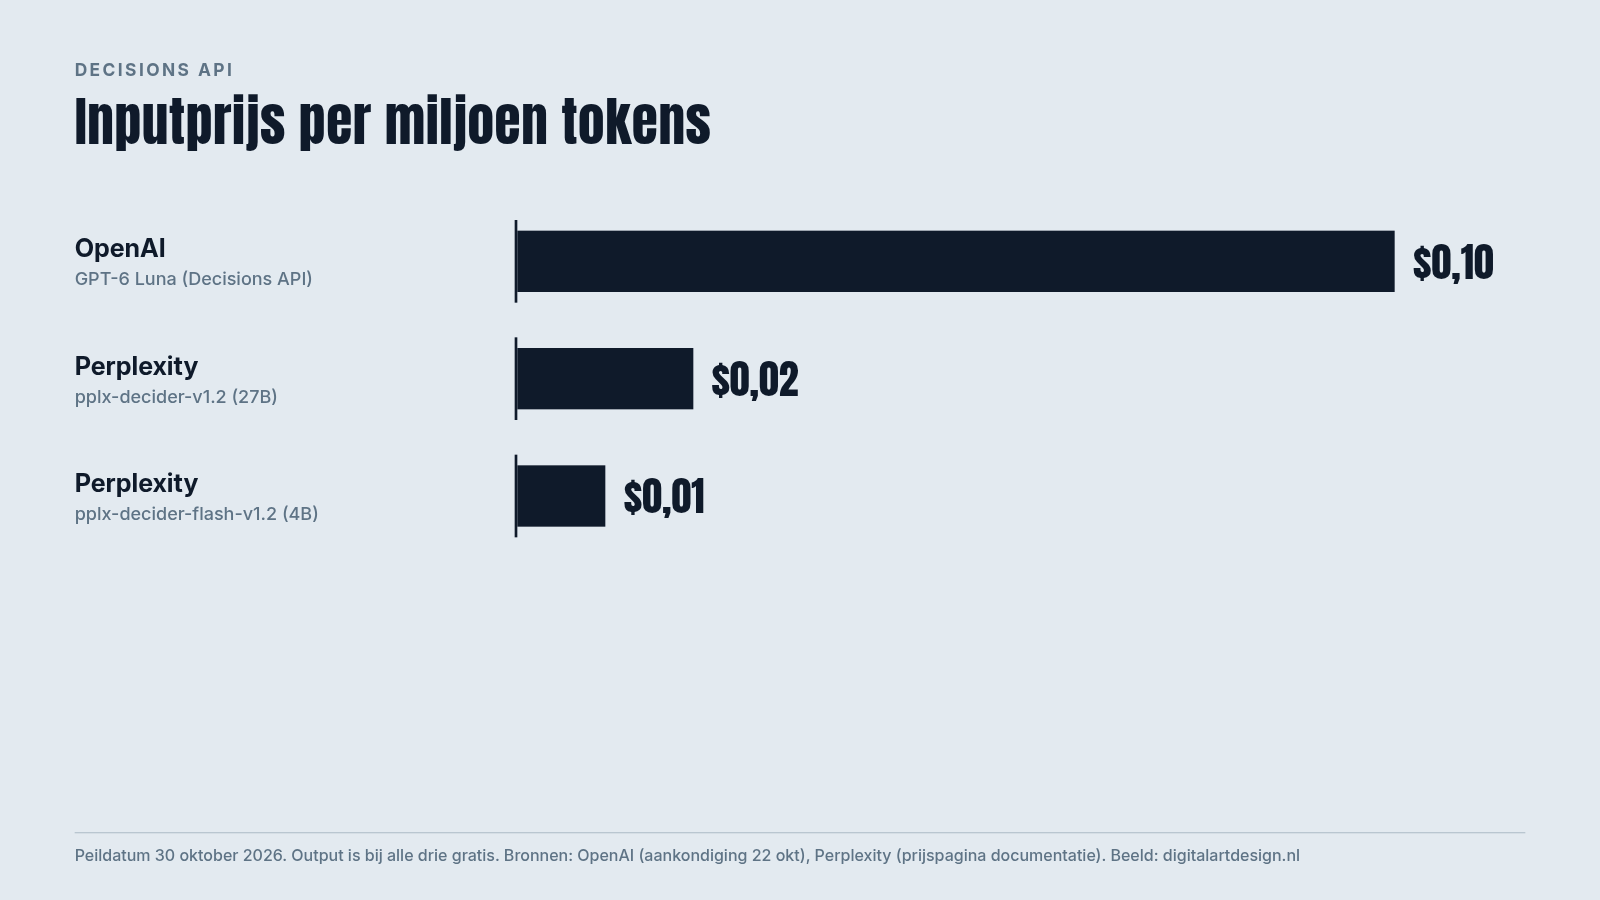
| OpenAI, GPT-6 Luna (Decisions API) | $0,10 | $0,01 | gratis |
| Perplexity, pplx-decider-v1.2 (27B) | $0,02 | niet vermeld | gratis |
| Perplexity, pplx-decider-flash-v1.2 (4B) | $0,01 | niet vermeld | gratis |
| Perplexity, Decider for Mac (lokaal, 4B) | geen kosten | n.v.t. | n.v.t. |
Peildatum: 30 oktober 2026. Prijzen van OpenAI uit de aankondiging van 22 oktober, prijzen van Perplexity uit de prijspagina in de documentatie.
Per token is Perplexity vijf tot tien keer goedkoper. Een token is bij beide aanbieders niet precies even groot, omdat ze elk een eigen tokenizer gebruiken, dus reken met je eigen teksten na voordat je kiest.
De rol van de Mac-app
Perplexity heeft ook Decider for Mac uitgebracht, een menubalk-app die het kleine 4B-model op je eigen computer draait. De app biedt dezelfde API aan op je eigen machine (127.0.0.1), zonder API-sleutel en zonder rekening. Je hebt volgens de documentatie een Mac met Apple silicon (M1 of nieuwer) nodig, macOS 13 of nieuwer, 16 GB werkgeheugen en ongeveer 6 GB vrije schijfruimte; het model zelf is 5,8 GB. Het idee: je test lokaal met gevoelige bestanden die je niet naar een cloud wilt sturen, en zet later dezelfde code over naar de gehoste API door de URL te veranderen.
Perplexity waarschuwt zelf dat de lokale versie een gecomprimeerde (q8_0) build is. Een drempelwaarde die je lokaal afstelt, moet je dus opnieuw controleren op het gehoste model.
Waar het wringt
De snelheids- en kostenclaims komen van de aanbieders zelf. OpenAI citeert vijf klanten, waaronder Datadog en Ramp, maar dat zijn door OpenAI gekozen voorbeelden zonder openbare testopzet, en ze vergelijken niet met hetzelfde. Datadog laat de API inschatten hoe riskant een door een agent bedachte shellopdracht is en meldt een 40 keer kortere p95-wachttijd (de tijd waarbinnen 95 procent van de antwoorden binnen is) dan bij ‘available frontier models’, zonder te zeggen welke. Ramp vergelijkt met ‘GPT-6 Luna’ en meldt vier keer sneller en 30 procent goedkoper. De ’tien keer sneller’ van OpenAI zelf gaat over hetzelfde model via de Responses API, niet over concurrenten.
Perplexity publiceert scores op zijn eigen benchmark, de Decision Index. Een onafhankelijke vergelijking tussen OpenAI en Perplexity op dezelfde taken hebben we niet gevonden. Ook zelf hebben we niet getest.
Beide modellen staan openbaar op Hugging Face onder de Apache-2.0-licentie, dus je mag de gewichten downloaden en ook commercieel gebruiken. De tekst op de modelkaarten zegt nog dat de repository ‘private’ is en dat je een token nodig hebt, maar dat klopt niet meer met de gegevens van Hugging Face zelf. Het grote model vraagt volgens de kaart een GPU met ruimte voor ongeveer 52 GiB aan gewichten, dus zelf draaien is alleen voor het kleine model realistisch.
Een beperking van het principe zelf: een model dat alleen kiest, legt niet uit waarom. Perplexity geeft zelf aan dat de kansen op onbekende taken ‘somewhat over-confident’ blijven. Voor beslissingen over mensen, zoals sollicitaties of kredieten, is een kans zonder uitleg geen goede basis.
Ook nieuw: caching in API en Codex
Volgens de changelog van OpenAI kun je in de API sinds 20 oktober kiezen voor prompt-caching van twaalf uur: gedeelde instructies blijven langer bewaard, zodat je minder betaalt als verzoeken uren uit elkaar liggen. Het opslaan in die cache kost 2,5 keer de normale inputprijs. In de desktop-app van Codex, de programmeeragent van OpenAI, kun je sinds 19 oktober ook een eerder bericht in een gesprek bewerken, meldde Codex-hoofd Thibault Sottiaux op X.
Wat je ermee doet
- Heb je een terugkerende, simpele beslissing in je software, zoals ‘is deze mail een klacht?’ of ‘naar welk team gaat dit verzoek?’, dan is een Decisions API goedkoper en sneller dan een chatmodel om een antwoord vragen.
- Werk je met gevoelige gegevens en heb je een Mac met Apple silicon, probeer dan eerst Decider for Mac. Je data verlaat je computer niet.
- Moet de verwerking in Europa blijven, dan biedt OpenAI dat expliciet. De privacypagina van Perplexity noemt geen verwerking in Europa, alleen Zero Data Retention voor klanten met een aparte overeenkomst.
- Test met je eigen voorbeelden en kijk vooral naar de gevallen waar het model onzeker is. Dat zijn de gevallen die een mens moet bekijken.
Bronnen
- Build more responsive apps with the Decisions API, OpenAI, 22 oktober 2026.
https://openai.com/index/decisions-api - Changelog, OpenAI API-documentatie, geraadpleegd 30 oktober 2026.
https://developers.openai.com/api/docs/changelog - Decisions (gids), OpenAI API-documentatie, geraadpleegd 30 oktober 2026.
https://developers.openai.com/api/docs/guides/decisions - Pricing, Perplexity API-documentatie, geraadpleegd 30 oktober 2026.
https://docs.perplexity.ai/docs/getting-started/pricing - Decider for Mac, Perplexity API-documentatie, geraadpleegd 30 oktober 2026.
https://docs.perplexity.ai/docs/decisions/decider-for-mac - pplx-decider-v1.2 (modelkaart), Perplexity op Hugging Face, geraadpleegd 30 oktober 2026.
https://huggingface.co/perplexity-ai/pplx-decider-v1.2 - pplx-decider-flash-v1.2 (modelkaart), Perplexity op Hugging Face, geraadpleegd 30 oktober 2026.
https://huggingface.co/perplexity-ai/pplx-decider-flash-v1.2 - Changelog, Perplexity API-documentatie, geraadpleegd 30 oktober 2026.
https://docs.perplexity.ai/docs/resources/changelog - Privacy & Security, Perplexity API-documentatie, geraadpleegd 30 oktober 2026.
https://docs.perplexity.ai/docs/resources/privacy-security - Day 14/ (post op X), Thibault Sottiaux (@thsottiaux), 19 oktober 2026.
https://x.com/thsottiaux/status/2111990254408434095