
ElevenLabs heeft Chimera gelanceerd, een tool die van een afbeelding en een geluidsfragment een video maakt waarin het personage spreekt. Chimera combineert het videomodel Seedance 2.5 met ElevenLabs V4. In een test waren de mondbewegingen redelijk overtuigend, maar de beeldkeuzes en de bediening lieten te wensen over.
Een foto en audio als basis
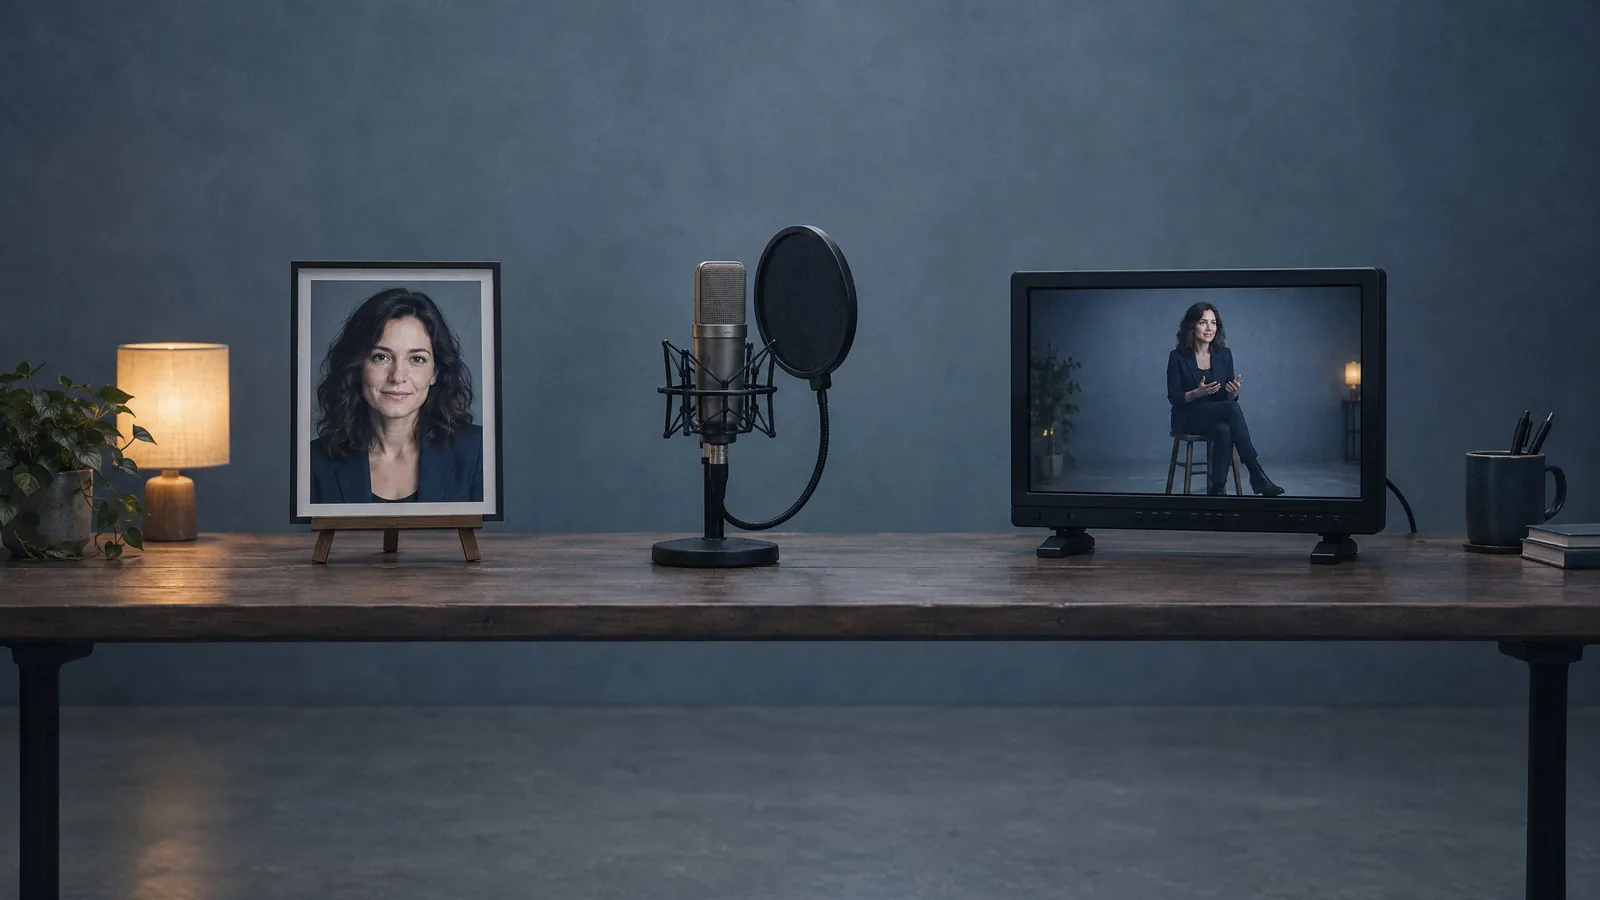
Je levert een afbeelding en audio aan. Chimera maakt daar een video van waarin de persoon op de foto de tekst lijkt uit te spreken.
In de besproken test werd een portretfoto gebruikt met een stem die ElevenLabs zelf had gegenereerd. Het was dus niet de echte stem van de persoon op de foto.
Meerdere shots in plaats van één portret
Chimera bleef niet bij het animeren van de foto. Het systeem bedacht eigen camerastandpunten en situaties: de persoon zittend op een kruk, een close-up en een scène met een spiegel. De houding van de oorspronkelijke foto kwam daardoor niet terug in de video.
Met een extra tekstinstructie kun je de beelden waarschijnlijk meer sturen. In deze test bleef dat veld bewust leeg.
De synchronisatie tussen spraak en mond vond de recensent redelijk overtuigend. Dat geldt voor deze ene test, niet als algemene kwaliteitsgarantie.
Waar de interface tekortschiet
Bij een lange tekst verdween de verzendknop uit beeld. Scrollen werkte niet goed, dus de recensent moest tekst selecteren en zo naar beneden slepen om de knop te bereiken.
Het tweede probleem kwam pas na het genereren van de spraak. Bij het toepassen van de audio meldde Chimera dat het fragment 120 seconden duurde, terwijl maximaal 30 seconden mag. Een waarschuwing tijdens het typen had die omweg bespaard.